
Tidak ada sistem yang benar-benar kebal terhadap kegagalan. Cloud dapat mengalami outage, jaringan dapat terputus, hardware dapat mengalami degradasi, dan kesalahan konfigurasi dapat memicu gangguan besar.
Karena itu, infrastruktur modern perlu dirancang bukan hanya untuk beroperasi dalam kondisi normal, tetapi juga untuk menghadapi kegagalan dengan dampak seminimal mungkin. Hybrid infrastructure dan redundancy engineering menjadi salah satu pendekatan dalam membangun sistem yang lebih tangguh melalui berbagai failure domain dan jalur operasional.
Artikel ini membahas bagaimana redundancy diterapkan pada DNS, network, application, data, hingga observability, serta bagaimana reliability dapat dibangun sebagai praktik yang terus diuji dan diperbaiki.
Table of Contents
Tidak Ada Sistem yang Benar-Benar Aman
Pada 7 Desember 2021, berbagai layanan internet seperti Netflix, Disney+, dan Slack tiba-tiba tidak dapat diakses. Gangguan tersebut bahkan berdampak pada layanan keuangan seperti Coinbase. Penyebabnya bukan serangan siber, melainkan aktivitas auto-scaling pada jaringan internal Amazon Web Services (AWS) di region us-east-1 yang kemudian memicu kegagalan berantai pada sistem DNS internal AWS.
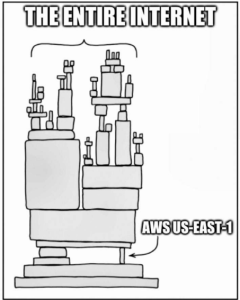
Gambar 1. Ketergantungan layanan internet pada satu region AWS.
Insiden tersebut menjadi pengingat bahwa infrastruktur milik penyedia cloud berskala besar pun tetap berkemungkinan mengalami kegagalan. Ketika satu komponen penting terganggu, dampaknya dapat menyebar ke berbagai layanan yang bergantung padanya.
Gangguang pada region AWS us-east-1 berlangsung selama hampir delapan jam dan membuat banyak layanan serta industri tidak dapat beroperasi secara normal. Peristiwa ini juga memperlihatkan satu persoalan penting yaitu memiliki infrastruktur di cloud tidak otomatis berarti memiliki sistem yang redundant atau siap menghadapi kegagalan.
Insiden serupa juga terjadi pada penyedia teknologi lainnya seperti pada Microsoft Azure, Google Cloud, dan Cloudflare yang menunjukkan masalah routing, dependensi tersembunyi, maupun kegagalan layanan inti dapat berdampak luas terhadap traffic dan layanan digital.
Di sinilah salah satu miskonsepsi mengenai cloud perlu diluruskan. Banyak yang menganggap bahwa ketika aplikasi sudah ditempatkan di cloud, risiko kegagalan otomatis berpindah sepenuhnya menjadi tanggung jawab provider.
Padahal, cloud tidak menghilangkan failure domain, cloud hanya mengubah di mana failure domain tersebut berada. Jika seluruh aplikasi masih bergantung pada satu region, satu availability zone, atau bahkan satu penyedia cloud, maka sistem tetap memiliki potensi single point of failure (SPOF). Dengan kata lain, memindahkan aplikasi ke cloud saja belum cukup untuk membangun infrastruktur yang benar-benar tangguh.
Lalu, bagaimana perusahaan dengan layanan digital berskala besar dapat tetap beroperasi ketika sebagian infrastrukturnya mengalami gangguan?
Jawabannya bukan sekadar menggunakan perangkat yang lebih mahal atau menambah kapasitas. Ketahanan sistem lebih banyak ditentukan oleh rancangan arsitektur, mulai dari komponen yang saling terhubung, cara gangguan dideteksi, dampaknya jika diisolasi, hingga bagaimana layanan dialihkan dan dipulihkan ketika terjadi kegagalan.
Karena itu, sistem yang reliable tidak dirancang dengan asumsi kegagalan tidak akan terjadi tetapi dibangun dengan asumsi suatu saat komponen tertentu akan gagal. Secara umum, pendekatan tersebut bertumpu pada empat prinsip:
Mengisolasi kegagalan agar dampaknya tidak menyebar dan memperbesar blast radius.
Mendeteksi anomali melalui observability sehingga gangguan dapat diketahui sedini mungkin.
Mengalihkan traffic atau workload ke infrastruktur cadangan melalui mekanisme failover.
Memulihkan layanan dengan intervensi manusia seminimal mungkin melalui mekanisme otomatisasi dan self-healing.
Keempat prinsip tersebut merujuk pada dua pendekatan penting dalam membangun infrastruktur yang lebih tangguh yakni hybrid infrastructure dan redundancy engineering. Keduanya bukan hanya konsep arsitektur, sebab jika dirancang dengan tepat, ini dapat menjadi bagian dari strategi untuk menjaga layanan tetap tersedia ketika cloud, jaringan, maupun data center mengalami gangguan.
Ketika Cloud dan On-Premises Sama-Sama Mengalami Kegagalan
Sebelum membahas bagaimana membangun sistem yang lebih tangguh, kita perlu memahami terlebih dahulu dari mana kegagalan dapat muncul.
Baik cloud maupun on-premises memiliki failure pattern masing. Perbedaannya terletak pada bagaimana kegagalan tersebut muncul, seberapa luas dampaknya, dan seberapa besar kontrol yang dimiliki perusahaan untuk mengatasinya. Dengan memahami pola tersebut, perusahaan dapat menentukan strategi redundancy yang lebih sesuai dengan kebutuhan bisnis.
Kegagalan di Sisi Cloud: Ketika Raksasa Juga Bisa Terpeleset
Dari kasus AWS us-east-1, setidaknya ada beberapa pola kegagalan yang perlu diperhatikan:
Cascading failure
Gangguan pada satu komponen dapat memicu efek domino ke komponen lain. Misalnya, peningkatan latency dapat memicu retry storm yang kemudian membebani service lain dan memperbesar dampak gangguan.
Control plane outage
Gangguan pada layanan seperti IAM, managed DNS, atau API orkestrasi dapat menyulitkan pengguna melakukan perubahan konfigurasi maupun proses pemulihan ketika gangguan terjadi.
Correlated failure
Beberapa komponen yang terlihat terpisah dapat tetap memiliki ketergantungan pada sumber daya atau lapisan infrastruktur yang sama. Akibatnya, kegagalan dapat berdampak pada lebih dari satu zone atau layanan secara bersamaan.
Artinya, memiliki beberapa instance atau bahkan beberapa workload di dalam cloud yang sama belum tentu cukup. Redundansi harus mempertimbangkan apakah komponen yang dibuat redundant benar-benar memiliki failure domain yang berbeda.
Kegagalan di Sisi On-Premises: Masalah yang Datang Perlahan
Jika cloud memiliki risiko yang berasal dari dependensi terhadap provider, on-premises menghadapi tantangan yang berbeda. Kegagalan pada infrastruktur on-premises dapat muncul secara perlahan, sulit terlihat, atau terjadi secara tiba-tiba. Sumber kegagalan yang perlu diperhatikan antara lain:
Degradasi Hardware
Pada infrastruktur on-premises, berbagai komponen hardware dapat mengalami degradasi seiring waktu. Beberapa di antaranya meliputi disk storage, power supply (PSU), kapasitor pada motherboard, hingga kabel fiber optic.
Disk storage memiliki nilai Mean Time Between Failures (MTBF) yang dapat digunakan sebagai salah satu indikator reliability dengan usia penggunaan disk umumnya berada pada rentang 3–5 tahun.
Selain storage, komponen lain juga dapat mengalami penurunan performa. Power supply (PSU), misalnya, dapat mengalami penurunan efisiensi dalam menyuplai listrik seiring waktu. Kapasitor pada motherboard juga dapat mengalami kegagalan, yang salah satu indikasinya adalah kondisi kapasitor menggembung. Pada sisi konektivitas, kabel fiber optic juga dapat mengalami degradasi sinyal yang pada akhirnya memengaruhi kualitas koneksi dan reliability sistem.
Kegagalan Lingkungan Fisik
Infrastruktur on-premises juga bergantung pada lingkungan fisik seperti sistem pendingin, sumber listrik, UPS, dan generator.
Kegagalan sistem pendingin tanpa redundancy dapat menyebabkan peningkatan temperatur dan berujung pada thermal shutdown. Begitu pula gangguan listrik yang berlangsung lebih lama dari kapasitas UPS dan generator dapat memaksa sistem melakukan hard shutdown.
Di luar itu, risiko seperti banjir, gempa, maupun kerusakan fasilitas juga tidak dapat diselesaikan hanya melalui software. Karena itu, strategi recovery perlu mempertimbangkan failure domain yang lebih besar dari sekadar satu ruang server atau satu gedung.
Keterbatasan Kapasitas dan Elastisitas
Berbeda dengan cloud yang relatif mudah melakukan scaling, kapasitas on-premises memiliki batas fisik. Lonjakan traffic yang tidak diperkirakan, misalnya saat flash sale, double-date campaign, atau event dengan jumlah pengguna tinggi dapat menyebabkan resource server tidak mencukupi. Tanpa capacity planning yang tepat, kondisi tersebut dapat berujung pada overload dan menurunkan performa layanan.
Human Operational Error
Faktor manusia juga menjadi bagian dari failure domain. Kesalahan ketika melakukan konfigurasi, maintenance, maupun pengelolaan hardware dan software dapat menyebabkan gangguan layanan. Karena itu, reliability tidak hanya bergantung pada teknologi, tetapi juga pada proses operasional, automation, dan guardrail yang membantu mengurangi risiko human error.
Mengapa Tidak Ada Satu Strategi yang Cocok untuk Semua?
Dari penjelasan di atas, bisa dibilang cloud dan on-premises sama-sama memiliki kelebihan sekaligus failure mode yang berbeda. Cloud menawarkan elastisitas dan berbagai mekanisme redundancy yang dikelola oleh provider, tetapi perusahaan tidak memiliki kontrol penuh terhadap lapisan fisiknya.
Sementara itu, on premises memberikan kontrol yang lebih besar terhadap hardware hingga software, tetapi seluruh pengelolaan kapasitas, maintenance, redundancy, dan recovery menjadi tanggung jawab perusahaan.
Oleh sebab itu, mengandalkan satu jenis lingkungan saja cukup berisiko untuk sistem yang bersifat mission critical. Sebelum menentukan antara cloud atau on premises, perusahaan sebaiknya merancang failure domain yang saling melengkapi agar selalu ada jalur cadangan saat terjadi gangguan. Di situlah pentingnya menerapkan arsitektur hybrid dan redundancy engineering.
Arsitektur yang Menjaga Sistem Tetap Berdiri
Setelah melihat bahwa kegagalan dapat berasal dari berbagai sisi, baik dari cloud, infrastruktur on premises, jaringan, hardware, maupun kesalahan operasional. Jika kegagalan tidak dapat dihindari, pertanyaan berikutnya adalah bagaimana merancang sistem agar tetap berjalan ketika salah satu komponennya gagal? Jawabannya dimulai dari arsitektur.
Sistem yang tangguh tidak bergantung pada satu komponen, satu jalur, atau satu lingkungan saja. Setiap komponen perlu dirancang dengan mempertimbangkan kemungkinan kegagalan agar gangguan pada satu bagian tidak langsung berdampak pada keseluruhan layanan. Dengan kata lain, arsitektur perlu meminimalkan single point of failure (SPOF).
Untuk mencapai tujuan tersebut, ada dua pendekatan yang saling melengkapi, hybrid infrastructure dan redundancy engineering. Hybrid infrastructure berfokus pada bagaimana workload ditempatkan di berbagai failure domain, sementara redundancy engineering memastikan tersedia komponen atau layanan cadangan ketika salah satu bagian mengalami kegagalan.
Pilar Pertama: Arsitektur Hybrid
Dalam konteks reliability, arsitektur hybrid bukan sekadar menempatkan sebagian workload di cloud sebagian lainnya di on premises. Tujuan utamanya mendistribusikan workload ke lingkungan dengan failure domain yang berbeda, sehingga gangguan pada satu lingkungan tidak langsung melumpuhkan seluruh layanan. Ada beberapa pendekatan yang dapat diterapkan, tergantung kebutuhan dan karakteristik workload.
Opsi 1: Multi-Cloud Active-Active
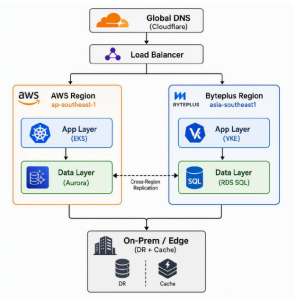
Gambar 2. Arsitektur multi-cloud active-active.
Pada arsitektur multi-cloud active-active, dua cloud environment melayani traffic secara bersamaan. Traffic dapat didistribusikan menggunakan load balancer, sementara global DNS dan CDN dapat membantu mengarahkan pengguna ke layanan berdasarkan lokasi geografis.
Pendekatan ini memungkinkan sistem tetap melayani traffic meskipun salah satu cloud mengalami gangguan. Penggunaan lebih dari satu cloud provider juga mengurangi ketergantungan pada satu vendor.
Namun, multi-cloud juga membawa tantangan tersendiri. Replikasi data lintas vendor dapat menjadi lebih kompleks, biaya data egress dapat meningkat, dan dibutuhkan abstraksi infrastruktur yang lebih matang untuk menjaga konsistensi pengelolaan di berbagai environment.
Gambar 2. Arsitektur multi-cloud active-active.
Opsi 2: Cloud dan On-Premise (Hybrid Cloud)
Pendekatan berikutnya adalah mengombinasikan cloud dengan infrastruktur on-premises. Dalam skenario ini, masing-masing environment dapat menangani workload sesuai karakteristik dan kebutuhannya.
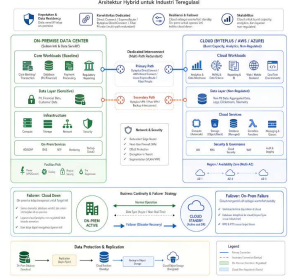
Gambar 3. Arsitektur hybrid cloud dan on-premise.
On-premises dapat digunakan untuk menangani data sensitif, seperti PII dan transaksi finansial, serta workload tertentu yang membutuhkan kontrol lebih besar. Sementara itu, cloud dapat digunakan untuk menangani traffic dan workload besar dari public internet, kebutuhan analitik, serta layanan yang tidak memiliki persyaratan regulasi yang ketat.
Agar kedua environment dapat bekerja sebagai satu kesatuan, konektivitas perlu dirancang secara andal. Beberapa opsi yang dapat digunakan antara lain private connection, Direct Connect, IPsec VPN, maupun koneksi fiber optic.
Opsi 3: Edge dan Centralized Cloud
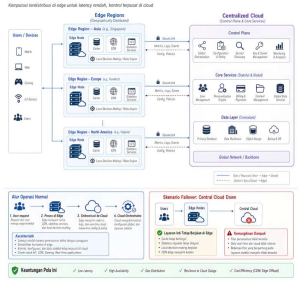
Gambar 4. Arsitektur edge dan centralized cloud.
Untuk aplikasi yang sangat sensitif terhadap latency, komputasi dapat didistribusikan lebih dekat ke lokasi pengguna atau sumber data melalui edge computing, sementara kontrol terpusat tetap berada di cloud.
Pendekatan ini umum digunakan pada aplikasi seperti CCTV, IoT, CDN, dan gaming. Dengan menempatkan proses komputasi di edge yang tersebar di berbagai lokasi geografis, sistem dapat mengurangi ketergantungan pada koneksi ke pusat sekaligus menjaga latency tetap rendah.
Ketiga pendekatan tersebut menunjukkan bahwa hybrid architecture bukan hanya tentang di mana workload ditempatkan, tetapi juga tentang bagaimana sistem menghindari ketergantungan pada satu failure domain. Namun, memiliki beberapa environment saja belum cukup. Setiap layer di dalam arsitektur juga perlu memiliki mekanisme redundansi. Di sinilah redundancy engineering menjadi pilar kedua.
Pilar Kedua: Redundancy Engineering
Jika arsitektur hybrid menentukan bagaimana workload didistribusikan, redundancy engineering menentukan berapa banyak komponen atau layanan cadangan yang diperlukan agar sistem tetap dapat berjalan ketika salah satunya gagal.
Redundansi yang efektif tidak cukup diterapkan pada satu bagian saja. Pendekatan ini perlu dilakukan secara berlapis, mulai dari DNS dan network hingga application, data, dan observability.
Lapisan 1: DNS dan Traffic Routing
DNS merupakan salah satu lapisan awal yang menentukan ke mana traffic pengguna akan diarahkan. Karena itu, lapisan ini juga perlu memiliki redundansi. Beberapa pendekatan yang dapat diterapkan:
Gunakan minimal dua penyedia DNS, misalnya Route 53 dan Cloudflare. Jika salah satu penyedia mengalami gangguan, penyedia lainnya tetap dapat melayani resolusi nama.
Terapkan active health check pada setiap endpoint agar traffic hanya diarahkan ke target yang sehat.
Gunakan Anycast atau GeoDNS untuk mendistribusikan traffic berdasarkan lokasi pengguna.
Lapisan 2: Network dan Load Balancing
Setelah traffic diarahkan, jaringan dan load balancing menjadi lapisan berikutnya yang perlu dirancang tanpa ketergantungan pada satu jalur. Beberapa pendekatan yang dapat digunakan meliputi:
Multi-path routing: hindari ketergantungan pada satu ISP atau satu jalur fiber dengan menggunakan BGP multi-homing.
Redundant load balancer: gunakan minimal dua instance load balancer dalam konfigurasi active passive atau active-active.
Service mesh: gunakan solusi seperti Istio atau Linkerd untuk mendukung traffic splitting, retry policy, dan mTLS antar-microservice.
Lapisan 3: Application dan Compute
Pada layer application dan compute, desain aplikasi juga perlu mendukung penggantian instance tanpa menyebabkan layanan berhenti atau kehilangan state. Beberapa prinsip yang dapat diterapkan:
Stateless design: aplikasi tidak menyimpan state di memori lokal. State disimpan pada external store sehingga instance dapat diganti tanpa kehilangan data.
Minimum replica: jalankan minimal tiga replica untuk setiap layanan dan distribusikan pada sedikitnya dua availability zone.
Kubernetes Pod Disruption Budget: menjaga jumlah minimum pod tetap tersedia selama proses seperti node drain atau upgrade.
Horizontal Pod Autoscaler: menambahkan replica secara otomatis ketika beban meningkat sehingga risiko overload dapat dikurangi.
Dengan begitu, kegagalan pada satu instance tidak langsung berarti kegagalan pada seluruh layanan. Namun, semakin ke bawah kita masuk ke stack, tantangannya menjadi lebih kompleks, terutama ketika menyangkut data.
Lapisan 4: Data dan Storage
Data merupakan salah satu layer yang paling kritis sekaligus paling sulit dibuat redundan karena melibatkan aspek konsistensi data. Beberapa strategi yang dapat digunakan memiliki trade-off masing-masing.
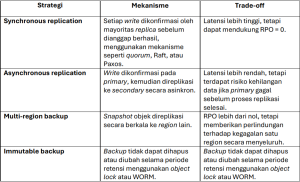
Tidak ada satu strategi yang selalu paling tepat. Pilihannya perlu disesuaikan dengan RPO yang dapat ditoleransi oleh bisnis. Sistem pembayaran, misalnya, dapat membutuhkan RPO = 0, sementara sistem analitik mungkin dapat mentoleransi RPO beberapa menit.
Lapisan 5: Observability dan Detection
Redundansi hanya akan efektif jika sistem dapat mengetahui kapan sebuah komponen mengalami masalah dan kapan failover perlu dilakukan. Karena itu, observability menjadi bagian penting dari reliability engineering.
Beberapa komponen yang dapat digunakan antara lain:
Metrics: Prometheus, Datadog, atau CloudWatch untuk memantau latency, error rate, dan saturation.
Distributed tracing: OpenTelemetry atau Jaeger untuk melacak request lintas layanan.
Alerting: PagerDuty atau OpsGenie dengan threshold yang mengacu pada SLO.
Health check endpoint: setiap layanan perlu menyediakan endpoint seperti /health dan /ready untuk diperiksa secara berkala.
Pada titik ini, terlihat reliability bukan sekadar menambahkan server atau membuat backup. Ketahanan sistem dibangun dengan menggabungkan failure-domain isolation, redundancy, detection, dan kemampuan untuk melakukan failover di berbagai layer.
Menggabungkan Hybrid dan Redundancy
Kekuatan terbesar muncul ketika arsitektur hybrid dan redundancy engineering diterapkan secara bersamaan. Hybrid architecture menyediakan lingkungan alternatif ketika sebuah failure domain mengalami gangguan, sementara redundancy memastikan setiap layer memiliki jalur atau komponen cadangan untuk tetap beroperasi.
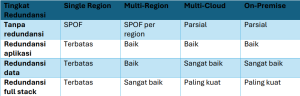
Namun, semakin tinggi tingkat redundansi yang diterapkan, semakin besar pula biaya dan kompleksitas yang harus dikelola. Tidak ada satu rancangan yang cocok untuk semua bisnis. Startup e-commerce mungkin cukup menggunakan multi-region dan redundansi pada layer aplikasi. Sebaliknya, organisasi dengan kebutuhan availability yang lebih tinggi dapat membutuhkan kombinasi multi-cloud, on-premises, dan redundansi full-stack.
Karena itu, tujuan reliability bukan memilih arsitektur yang paling mahal, melainkan menentukan tingkat ketahanan yang sesuai dengan kebutuhan bisnis, RTO, dan RPO, kemudian mengujinya secara berkala.
Reliability adalah Budaya yang Harus Dibangun
Setelah membahas berbagai sumber kegagalan pada cloud dan on-premises, serta bagaimana hybrid architecture dan redundansi berlapis dapat membantu sistem tetap berjalan ketika sebagian infrastruktur mengalami gangguan, ada satu hal yang tidak dapat diselesaikan hanya dengan Terraform, Kubernetes, atau layanan cloud, reliability membutuhkan kesiapan tim dan proses yang konsisten.
Arsitektur hybrid yang dirancang dengan baik tetap dapat gagal jika tim tidak pernah melakukan failover drill. Redundansi multi-region juga tidak banyak membantu jika alert diabaikan atau tim tidak tahu bagaimana harus merespons ketika insiden terjadi. Begitu pula dengan circuit breaker dan bulkhead pattern yang manfaatnya tidak akan maksimal tanpa evaluasi dan postmortem setelah insiden.
Artinya, reliability bukan hanya tentang seberapa tangguh infrastrukturnya, tetapi juga tentang seberapa siap organisasi menghadapi kegagalan ketika itu benar-benar terjadi.
Trade-off yang Harus Diterima
Membangun sistem yang lebih tangguh tentu memiliki konsekuensi. Tidak ada arsitektur yang sempurna, dan setiap keputusan terkait reliability akan membawa trade-off tertentu.
Biaya: Redundansi membutuhkan kapasitas tambahan yang mungkin hanya digunakan ketika terjadi gangguan atau bencana.
Kompleksitas: Multi-cloud dan hybrid infrastructure menambah lapisan operasional yang membutuhkan keahlian, proses, dan tooling yang lebih matang.
Kecepatan: Validasi, DR drill, dan change management yang lebih ketat dapat menambah waktu dalam siklus pengembangan dan rilis.
Namun, trade-off tersebut bukan alasan untuk mengabaikan reliability. Tingkat ketahanan perlu disesuaikan dengan risiko dan dampak bisnis yang mungkin terjadi.
Tidak semua aplikasi membutuhkan tingkat reliability yang sama. Aplikasi internal untuk manajemen cuti, misalnya, memiliki kebutuhan yang berbeda dengan sistem pembayaran nasional. Dengan mempertimbangkan business impact, organisasi dapat menentukan tingkat redundancy, availability, dan recovery yang benar-benar dibutuhkan tanpa membangun kompleksitas yang berlebihan.
Mulai dari Satu Langkah Kecil
Menerapkan seluruh pendekatan reliability sekaligus mungkin terasa berat, terutama bagi tim kecil atau organisasi dengan anggaran terbatas. Karena itu, reliability tidak harus dibangun dalam satu langkah besar. Penting untuk memulai dari praktik sederhana dan menjalankannya secara konsisten.
Beberapa langkah yang dapat dilakukan antara lain:
Tentukan satu SLO. Definisikan seperti apa kondisi “tersedia” untuk sebuah layanan dan gunakan SLO tersebut sebagai acuan untuk keputusan arsitektur berikutnya.
Jalankan satu chaos experiment. Misalnya, matikan satu pod di environment staging atau putuskan satu jalur jaringan untuk melihat apakah sistem benar-benar dapat pulih.
Lakukan DR drill secara berkala. Simulasikan kegagalan region, ukur waktu pemulihan, dokumentasikan hasilnya, lalu gunakan temuannya untuk melakukan perbaikan.
Tulis blameless postmortem setelah insiden. Fokuskan evaluasi pada apa yang gagal dalam sistem dan bagaimana mencegah kejadian serupa, bukan pada siapa yang harus disalahkan.
Langkah-langkah tersebut mungkin terlihat sederhana. Namun, ketika dilakukan secara konsisten, tim akan bergerak dari sekadar bereaksi terhadap insiden menjadi lebih siap mengantisipasi, membatasi, dan memulihkan dampaknya.
Reliability Dimulai dari Lebih dari Sekadar Teknologi
Gangguan akan selalu menjadi bagian dari dunia infrastruktur. Cloud dapat mengalami outage, sebuah region dapat kehilangan availability, kabel fiber dapat terputus, disk dapat mengalami kegagalan, dan kesalahan konfigurasi tetap mungkin terjadi.
Karena itu, yang perlu dipersiapkan bukan hanya infrastrukturnya, tetapi juga bagaimana sistem dan tim dapat merespons ketika kegagalan benar-benar terjadi.
Hybrid architecture dapat menyediakan lingkungan alternatif untuk beralih, sementara redundansi memberikan lebih dari satu jalur untuk tetap beroperasi. Observability membantu tim mengetahui ketika sesuatu mulai gagal, dan otomatisasi memungkinkan respons dilakukan dengan lebih cepat.
Namun, teknologi saja tidak cukup. Reliability juga bergantung pada bagaimana sistem dirancang, bagaimana perubahan dikelola, bagaimana kegagalan diuji, dan bagaimana tim merespons ketika insiden terjadi.
Pada akhirnya, membangun sistem yang tangguh bukan pekerjaan yang selesai ketika arsitektur sudah dibuat. Sistem perlu terus diuji, asumsi perlu terus dipertanyakan, dan proses perlu terus diperbaiki.
Bagi Anda yang ingin memperdalam pengetahuan seputar cloud, infrastructure, dan praktik teknologi lainnya, iCCom (Indonesia Cloud Community) dapat menjadi salah satu tempat untuk belajar, berbagi knowledge dan best practice, serta terhubung dengan komunitas cloud enthusiast dan technologist di Indonesia.
Editor: Wilsa Azmalia Putri
Content Writer CTI Group
